Dans un système de recommandation classique, chaque annonce que tu lances porte un identifiant qui n'appartient qu'à elle. Le modèle apprend ce que vaut cet identifiant en regardant les gens qui voient l'annonce, cliquent et achètent. Tant que personne ne l'a vue, il ne sait pas à quoi la rattacher. Le 19 octobre 2026, six ingénieurs de Meta ont décrit sur le blog Engineering at Meta la façon dont ils remplacent ce numéro par une description de l'annonce.
La GenRecs Tokenization est la façon dont Meta représente chaque annonce, produit ou page : une courte suite de tokens tirés d'un vocabulaire sémantique stable, que des éléments semblables partagent, à la place d'un identifiant propre à chaque élément. Elle nourrit les GenRecs, pour Generative Recommenders, des modèles qui raisonnent à la fois sur le contenu d'une annonce et sur les préférences de la personne, avec l'architecture des LLM. Associée à GEM et à l'Adaptive Ranking Model, deux autres modèles de Meta, elle a apporté +0,35 % de conversions sur l'ensemble des surfaces, d'après une mesure interne de Meta de février 2026.
Pour toi, annonceur, elle change surtout le sort d'une annonce neuve. Voici le mécanisme, ce que Meta en annonce, ses limites, et ce que j'en tire pour tes créas.
Du Numéro Éphémère Au Vocabulaire Stable
Un identifiant est une étiquette collée sur une boîte fermée. Il ne dit rien de ce qu'il y a dedans, et il disparaît avec l'annonce : Meta parle d'ailleurs d'identifiants « éphémères ». Tout ce que le modèle sait d'une annonce, il l'a appris en la diffusant.
La tokenization ouvre la boîte. Des modèles multimodaux pré-entraînés lisent chaque annonce, chaque produit et chaque page, texte et images compris, et les traduisent en une représentation qui porte une connaissance générale du monde. Le tokenizer y combine ce que Meta a appris de la façon dont les gens interagissent avec ces éléments, puis réduit le tout à une courte suite de tokens. Meta le résume d'une image : les éléments semblables partagent des tokens, comme les mots d'une même famille partagent une racine. Chaussure, chausson et chausser n'ont pas besoin d'une définition chacun pour que tu devines qu'ils parlent du pied.
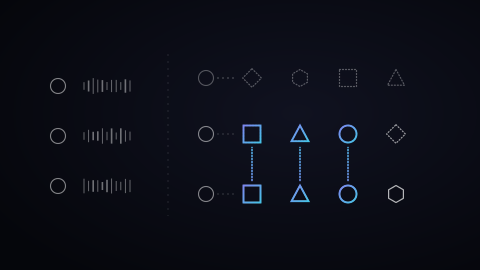
Le passage de l'annonce à ses tokens suit trois étapes :
- Encoder : chaque élément est placé dans un espace où deux éléments proches ont un sens proche.
- Décomposer : cette représentation est découpée en sous-espaces indépendants.
- Quantifier : chaque sous-espace est associé à une entrée d'un codebook, un répertoire fixe de codes. Ces codes sont les tokens.
Pour beaucoup d'annonces, Meta enchaîne ces codes par préfixes : les premiers tokens rangent l'élément dans une grande famille, les suivants précisent. Deux chaussures de running partagent le début de leur suite, une chaussure et une crème solaire beaucoup moins. Le vocabulaire forme ainsi une hiérarchie, du plus large au plus précis, et il reste le même d'une campagne à l'autre.
Ta Nouvelle Annonce Hérite De Ce Qu'Elle Montre
L'exemple de Meta parle à tout annonceur e-commerce. Une marque de sport lance la chaussure de trail de la saison suivante. Avec un identifiant, la nouvelle annonce recevait une représentation neuve, sans aucun signal. Avec des tokens, le nouveau produit et ses annonces s'appuient sur ce que le modèle a appris de la chaussure de la saison passée, avant même que quelqu'un voie la nouvelle annonce.
Meta cite les cas où cet héritage compte le plus :
- Les nouvelles entités : les annonces qui viennent d'être créées, les produits de niche, les pages qui ont peu d'engagement.
- La traîne : les annonces qui cumulent peu d'impressions, que le modèle rapproche désormais des autres par leur contenu commun. Meta écrit que c'est là que les tokens contribuent le plus.
- Le passage d'une campagne à l'autre : un vocabulaire stable transporte ce qui a été appris d'une campagne vers les suivantes.
Un effet de second ordre suit. Mieux prédire les annonces de la traîne améliore les données sur lesquelles le modèle s'entraîne, et ces données améliorent à leur tour les prédictions pour toutes les annonces. Meta parle d'un flywheel, une boucle de feedback qui gagne en vitesse à chaque tour.
Un second chiffre vient de la présentation des résultats du troisième trimestre, le 21 octobre 2026. Susan Li, directrice financière de Meta, y indique que Meta Generative Recommender, lancé en generative retrieval sur le fil Facebook, a produit une hausse de près de 2 % des conversions sur les segments ciblés (transcription de l'appel). Ce chiffre porte sur l'approche GenRecs dans la sélection des annonces candidates, et la tokenization n'en est qu'une brique.
Ces deux pourcentages sont des chiffres de Meta : des moyennes sur tous les annonceurs, mesurées sur des systèmes qui tournent ensemble. Ton gestionnaire de publicités ne les isole nulle part, et ils ne disent rien de ton compte en particulier.
Ce Que Ça Change Pour Tes Créas
Si une annonce est décrite par ce qu'elle montre, son texte et ses images deviennent son premier signal, avant sa première impression. Pour qui suit Meta, la direction est connue. Ma checklist d'audit Meta le dit déjà, dans le piège de sa section créas : « depuis Andromeda, le ciblage repose d'abord sur les créas ». Andromeda est le système de récupération de Meta, celui qui présélectionne les annonces candidates. La tokenization va dans le même sens, un étage plus bas : le contenu de ta créa devient la matière même de sa représentation.
Deux conséquences pratiques en découlent. Meta ne détaille aucun de ces cas : c'est ma lecture du mécanisme, et je la donne comme telle.
Je pense qu'une déclinaison qui ne change que la couleur du fond apprend peu de chose au modèle. Elle montre le même objet, le même message et la même promesse que l'original : ses tokens ont toutes les chances de lui ressembler, et elle se range à côté de lui. Un nouvel angle montre autre chose, un autre usage, une autre personne, une autre objection levée. C'est lui qui ouvre au système une nouvelle piste.
Je ne recommande pas de relancer une créa fatiguée en la dupliquant. La copie porte un nouvel identifiant, et elle montre exactement la même chose que l'originale. Dans un système qui lit le contenu, elle n'apporte donc au modèle aucune information nouvelle. Ma checklist demande que les créas fatiguées soient « renouvelées, pas juste relancées » : la tokenization donne une raison de plus de s'y tenir.
Les Limites, Et D'Où Vient L'Idée
Meta ne décrit aucun réglage à activer. La tokenization tourne dans ses modèles, pour tous les annonceurs, et elle sert aussi bien la récupération, qui choisit les annonces candidates, que le classement, qui les ordonne. Elle couvre tous les types d'éléments du système : annonces, produits, pages et pixels. D'après l'article, sa couverture s'étend encore à l'ensemble des éléments : tout ton catalogue n'est donc pas forcément concerné aujourd'hui.
L'idée vient de la recherche, et sa lignée se suit en trois articles :
- 2023, TIGER : des chercheurs de Google DeepMind et de Google proposent de générer directement l'identifiant sémantique de l'élément suivant, et montrent que la méthode recommande mieux les éléments sans historique (arXiv 2305.05065).
- 2023, YouTube : une équipe de Google DeepMind et de Google remplace les identifiants de vidéos par des semantic IDs dans un modèle de classement de YouTube, avec une meilleure généralisation sur les vidéos neuves et la traîne (arXiv 2306.08121).
- 2025, Meta : AI at Meta intègre des semantic IDs à préfixes dans le classement de ses annonces en production (arXiv 2504.02137). Kaushik Rangadurai cosigne cet article et celui d'octobre 2026.
La nouveauté de 2026 tient donc à l'échelle : un vocabulaire commun à tous les types d'éléments, en production, pour la récupération comme pour le classement. Meta dit explorer l'étape suivante : un même espace de tokens pour le texte, l'image, l'audio et la vidéo des annonces, qui représenterait d'un seul tenant ce qui intéresse une personne et ce qu'un annonceur propose.
Ce Que Tu Peux Faire Dès Ta Prochaine Campagne
Je recommande de commencer par ce que tes créas montrent, avant de toucher au ciblage :
- Décris chaque créa en une phrase : ce qu'elle montre, à qui, avec quelle promesse. Deux créas qui donnent la même phrase sont deux variantes d'un même angle.
- Varie les angles : je préfère deux angles vraiment différents plutôt que cinq couleurs du même visuel. Le calculateur de test de créas Meta te dit combien de créas ton budget de test peut porter sérieusement.
- Montre clairement ce qu'est un nouveau produit : son image et son texte sont ce que le modèle lit en premier. Un produit difficile à identifier sur le visuel se rattache mal à ce que le modèle connaît déjà.
- Renouvelle une créa fatiguée par un nouvel angle : le détecteur de fatigue publicitaire repère le jour où elle commence à s'user.
- Juge sur ton compte : suis le coût par résultat de tes nouvelles annonces sur leurs premiers jours, lancement après lancement. Ton propre historique reste le seul repère qui parle de ton compte.
Une nouvelle annonce part désormais de ce à quoi elle ressemble. Ma recommandation est de traiter chaque créa comme la description de ton offre que le modèle lit avant toute impression. Je te propose de passer tes créas actives au test de la phrase avant ton prochain lancement : celles qui donnent la même phrase gagnent à céder leur place à un nouvel angle. Pour un regard extérieur sur ton compte, découvre l'accompagnement Facebook Ads.